【Seedance2.0基础实操】如何最低成本控制AI视频中的人物站位,“场景锚定图”的应用和使用方法

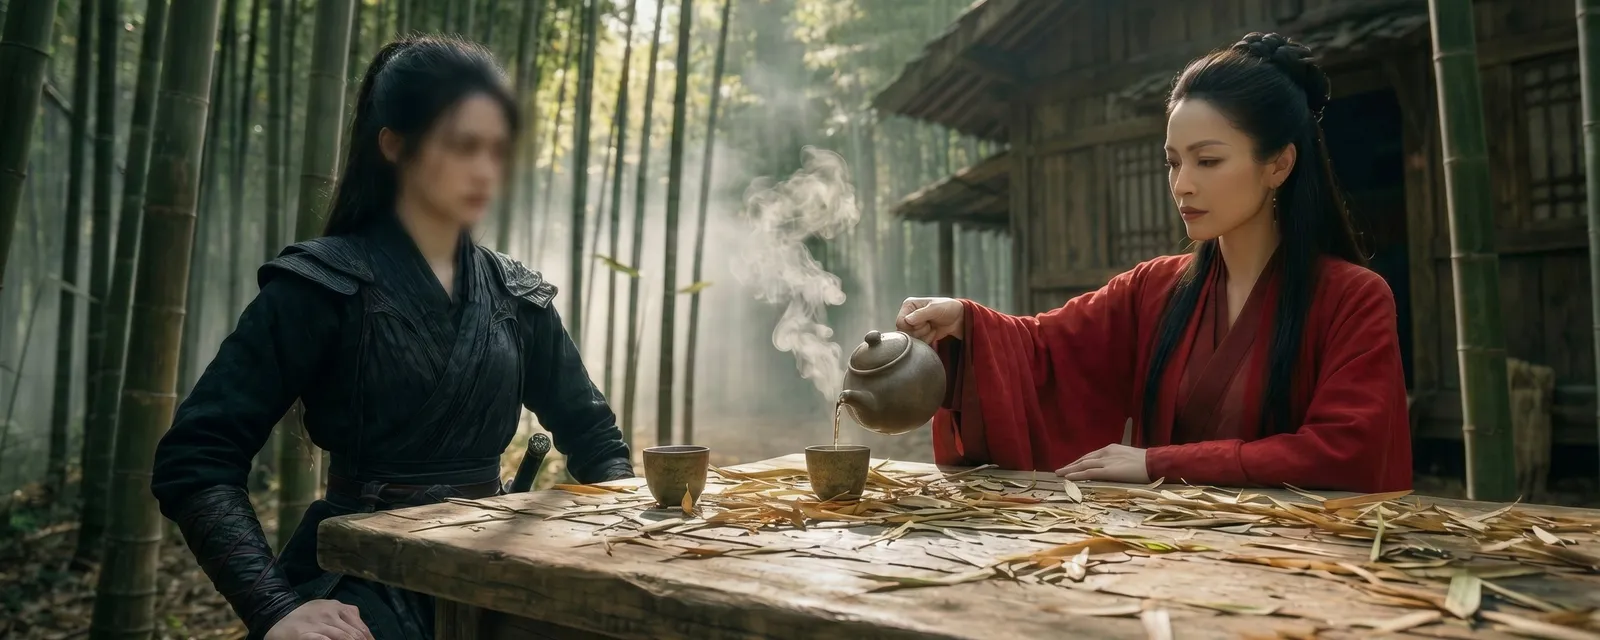
做过AI视频的都知道,最难的不是酷炫的武打动作,而是如何在同个场景下 精准的控制人物的站位和走位。那么,如何在不做首尾帧,分镜图的前提下,较好的控制生成出来视频的人物站位。
今天分享我制作过程中常用的流程:1-2张场景锚定图(或者叫关键帧场景图)+人物角色图+场景图。
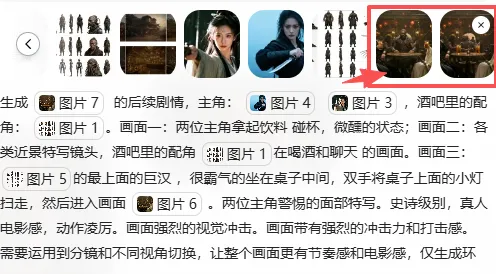
先看几段视频:
提示词几乎是完全一样的,区别在于加了“场景锚定图”/关键帧,画面里的人物完全不受控制
下面这个视频,即使使用了gpt 生成的拍摄脚本,人物依旧会乱站位
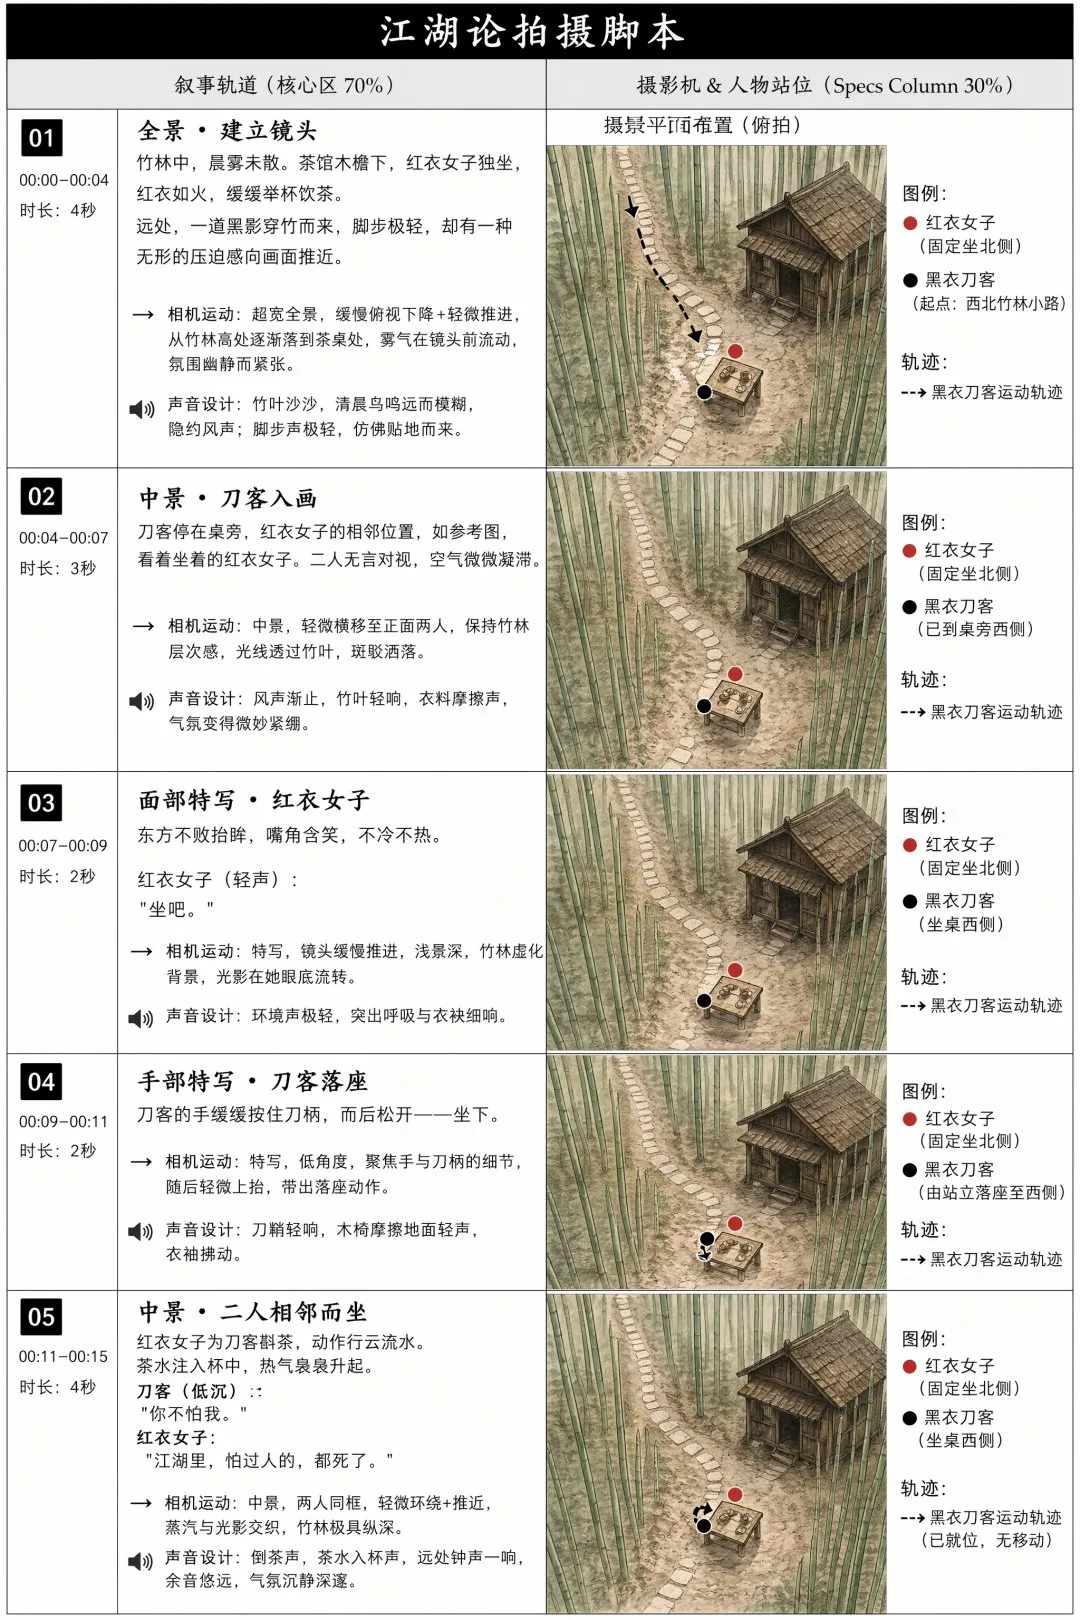
但是多加了一张“场景锚定图”/关键帧画面,立刻顺畅多了
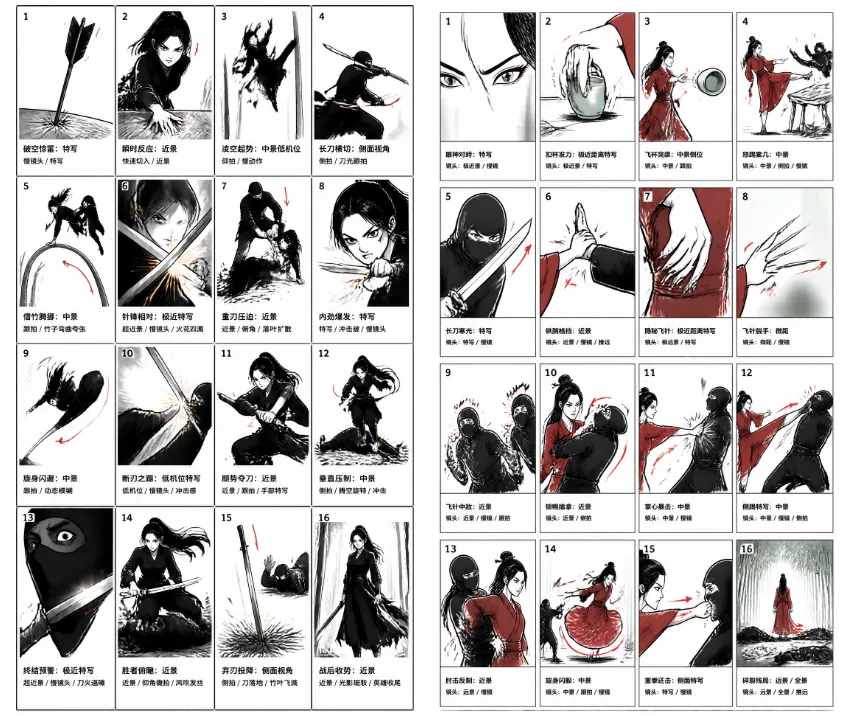
后面做类似的多人的武打画面,我也会先做对应的场景锚定图,配合武打分镜草图,抽卡成功率接近100%
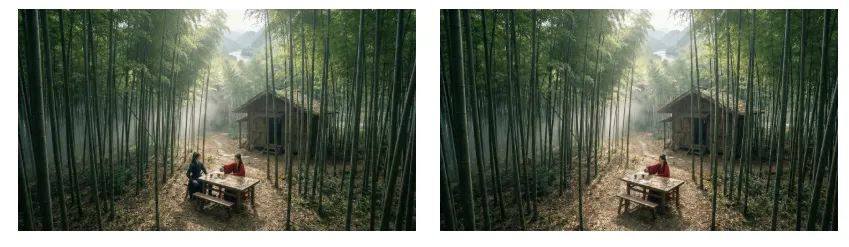
如何生成场景锚定图/关键帧画面?
我最常用的模型是香蕉模型(细节比较),提示词描述使用自然语言进行描述就
场景参考图的来源,一般有两种:
1.基于场景图,生成该视角的图片
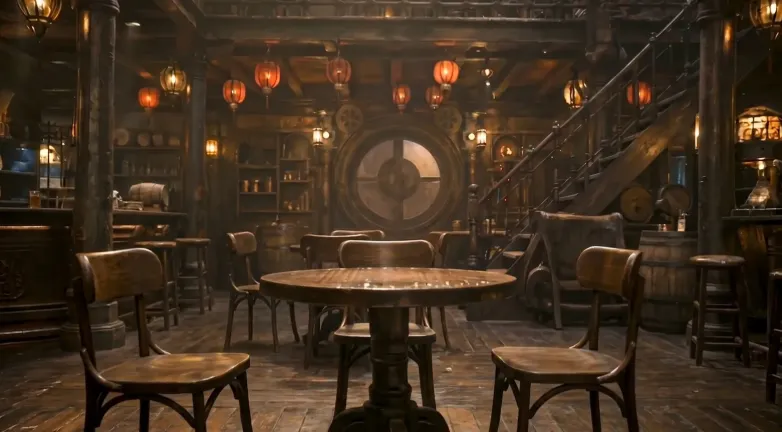
2.截取前一段视频的关键场景画面(我比较常用)
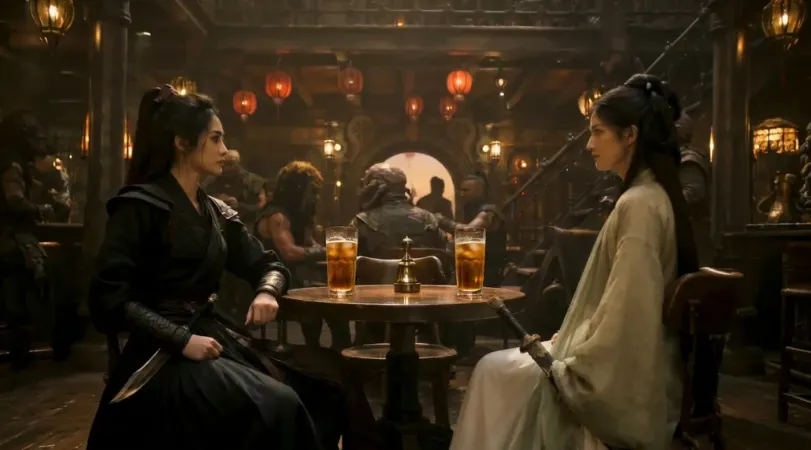
接着,用自然语言提示词进行描述生成即可
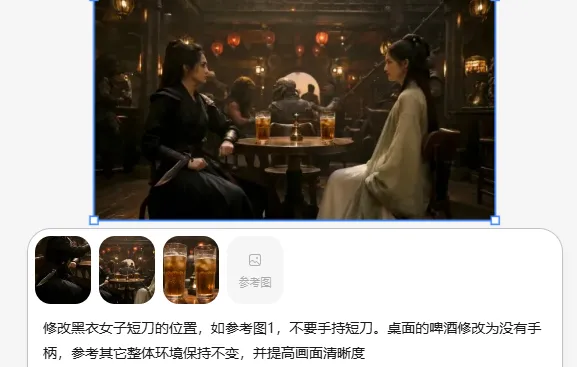
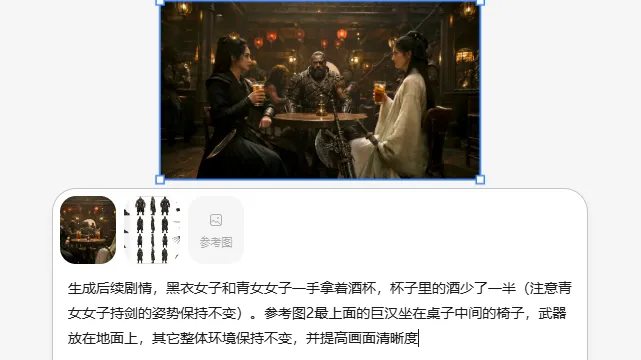
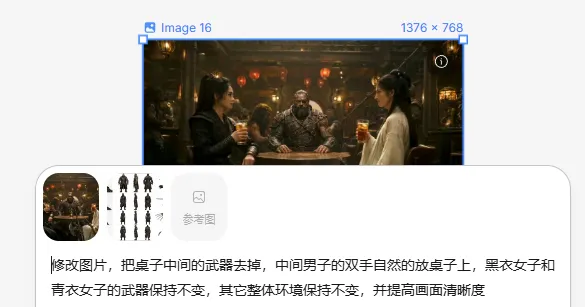
一些工具也提供了画笔标注的功能,画出人物的位置,再进行生成,成功率更高
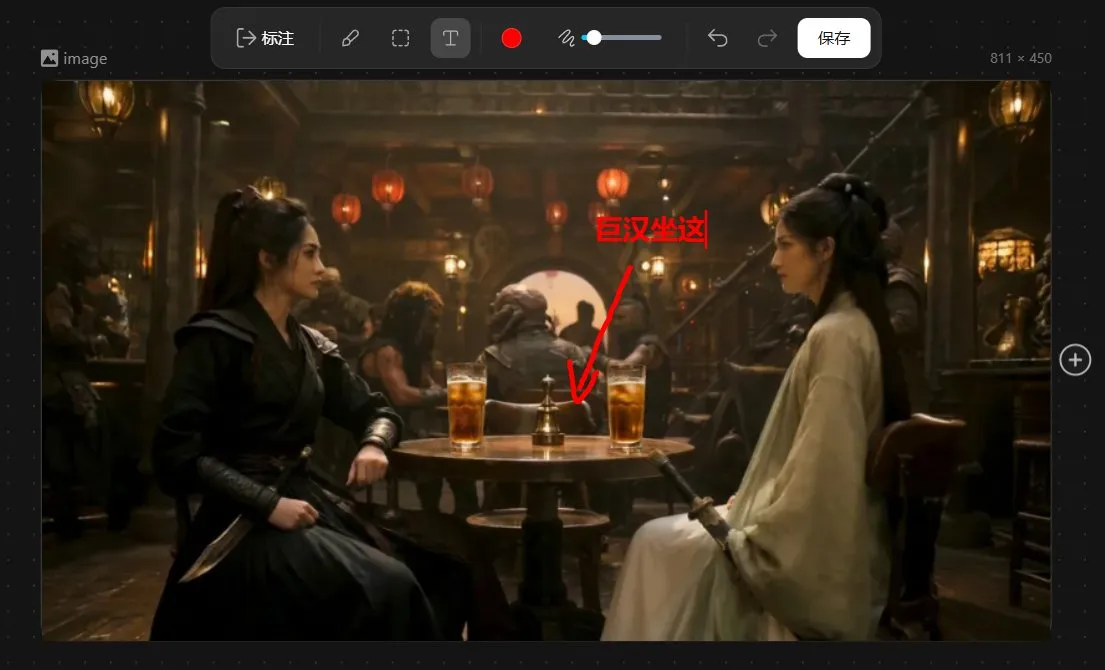
中间位置,AI一般能认得出,所以不用强制标注。左右的话建议 就先标注下。
注意事项:
1.生成的画面尽量为静态的某一帧画面,打斗画面的分镜交给seedance 2.0 去做即可
2.香蕉模型生成东方人脸的一致性比较差,可以将人脸虚化,把人物一致性的保持,统一交给seedance 2.0处理
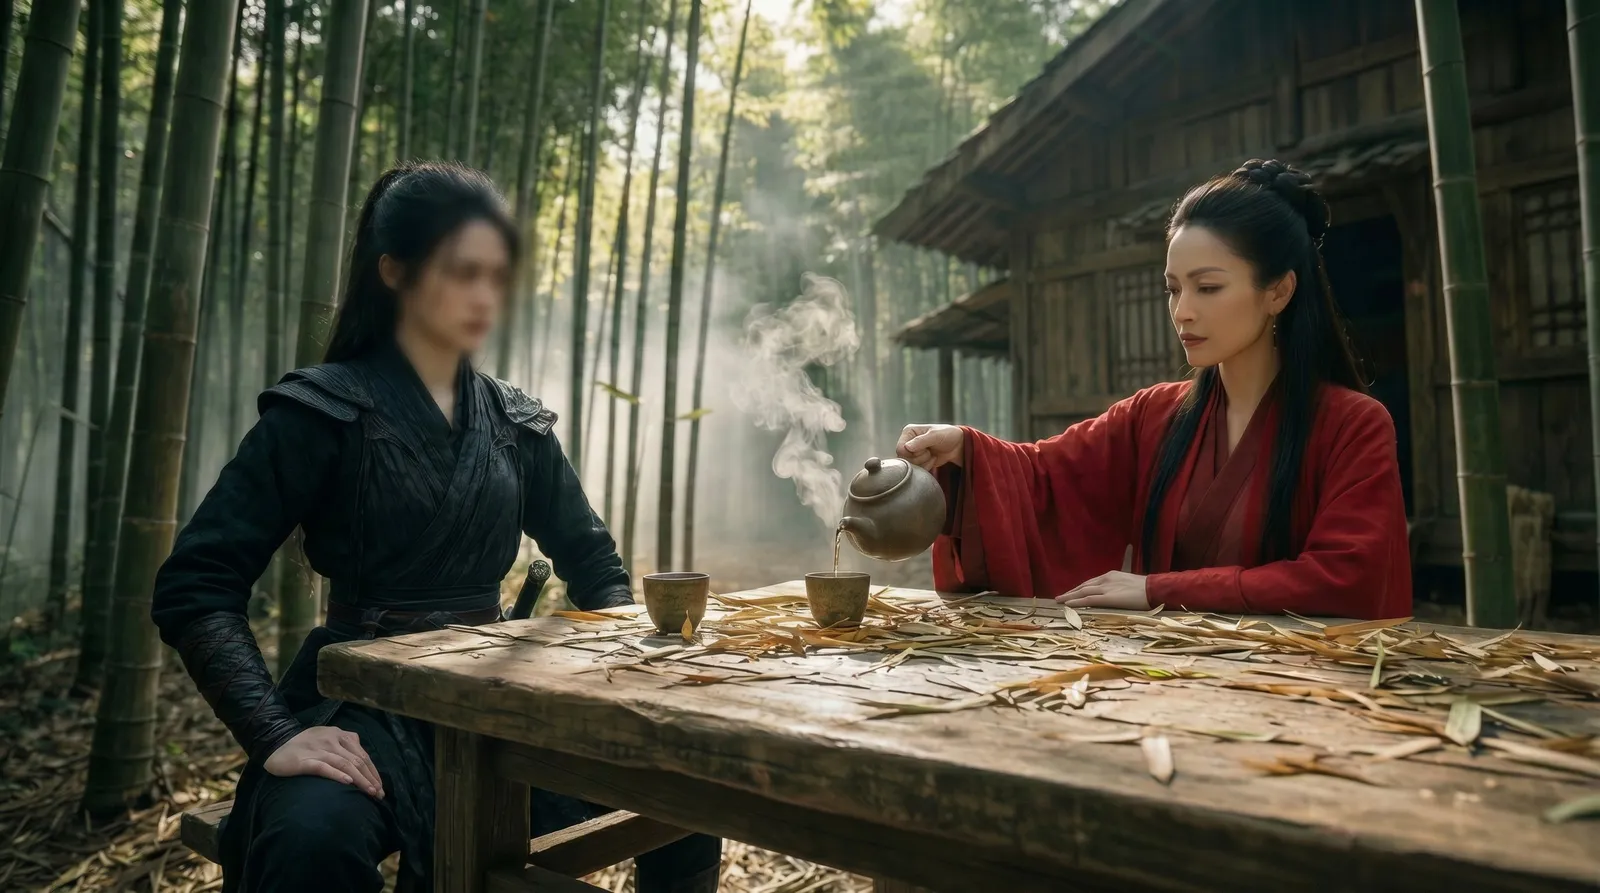
3.用红笔标记,图片生成的提示词 记得加上不要 生成带红笔标记的部分
除了上述办法,我看有些朋友也通过故事板来控制人物的站位。
但是目前对于比较复杂的场景,我这边尝试的成功率还不是很高,加上生图阶段也需要抽卡,所以目前使用故事板来控制还比较少。
大家有没有更好更低成本的方法,欢迎评论区交流。 喜欢此类教程的欢迎点赞和转发,我持续更新。
完整AI短片/短剧 制作流程学习和交流,欢迎添+V了解:Path_tanluai