【Seedance2.0基础实操】如何保持人物音色一致性?分享三个常用方法

目前AI视频仅支持生成15秒的视频。那么,15秒以后的视频应该如何人物音色一致性。今天跟大家分享三个常用方法。
方法一:直接参考前序视频的音色生成
该方法是我现在比较常用的方法,流程很简单分为几步:截取视频台词部分(保留人声)→提取音频→上传音频作为参考→提示词描写:音色参考该音频
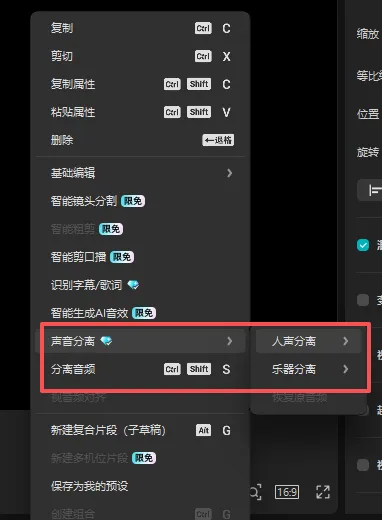
【保留人声和提取音频】这步可以使用剪映自带的功能——(右键视频片段,找到声音分离和分离音频)
声音分离:可以仅保留人声,去掉bgm,环境音等
分离音频:将视频分成一个无声视频和一段音频文件(音频文件可以单独导出)
也可以使用libtv 这种画布类型的产品
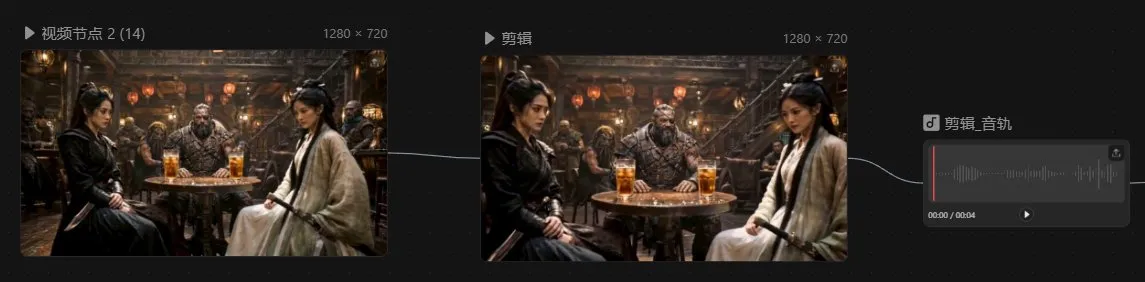
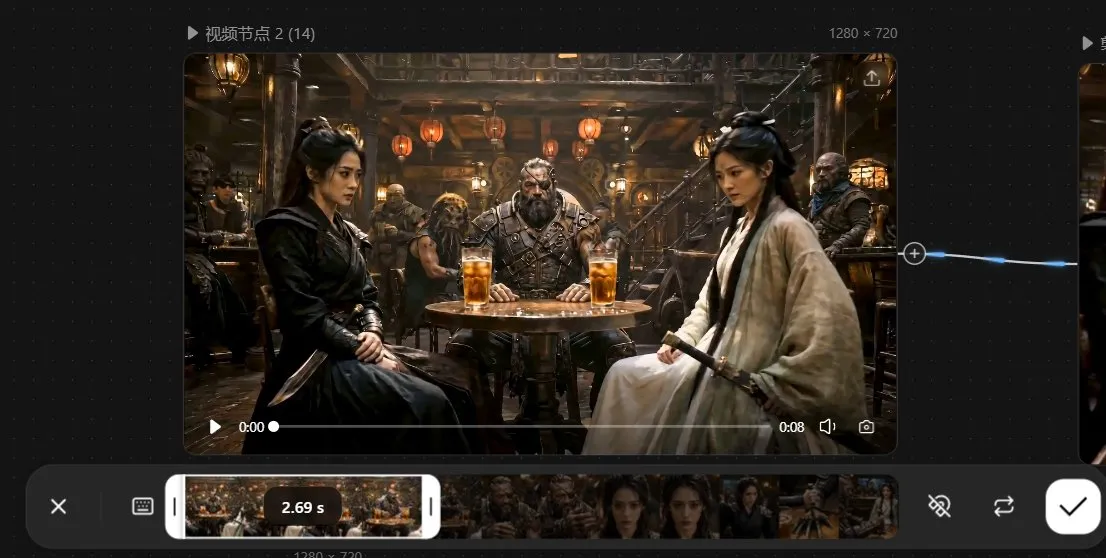
第一步先裁剪出人声的视频片段
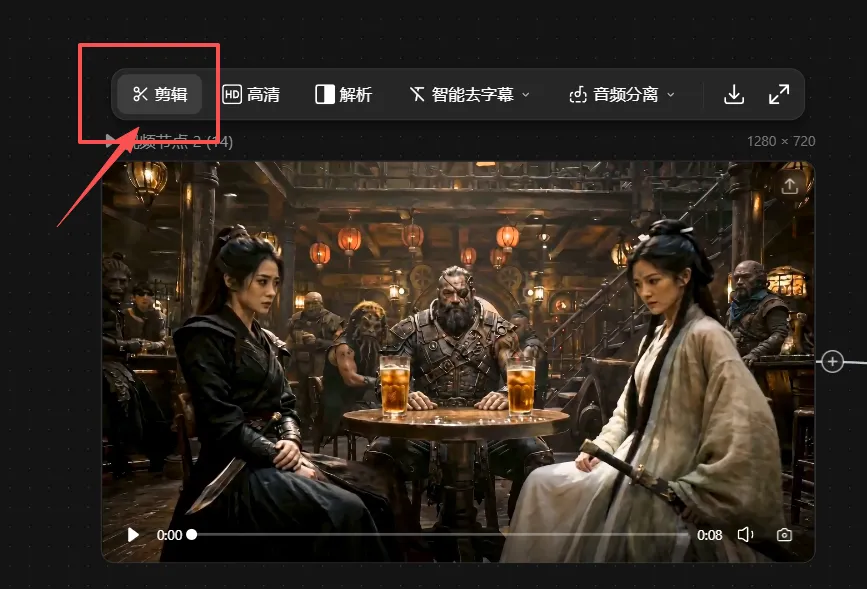
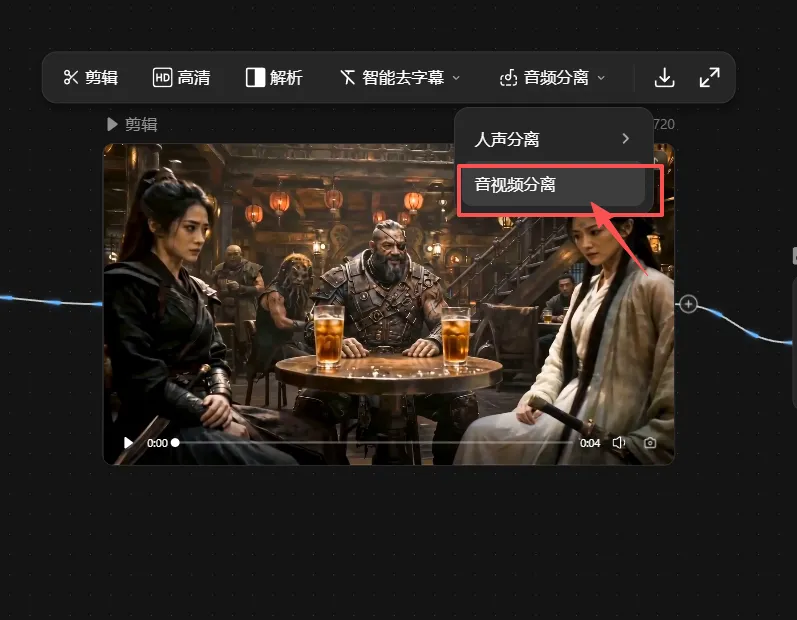
第二步再使用它的音频分离功能,就得到了一个音频文件
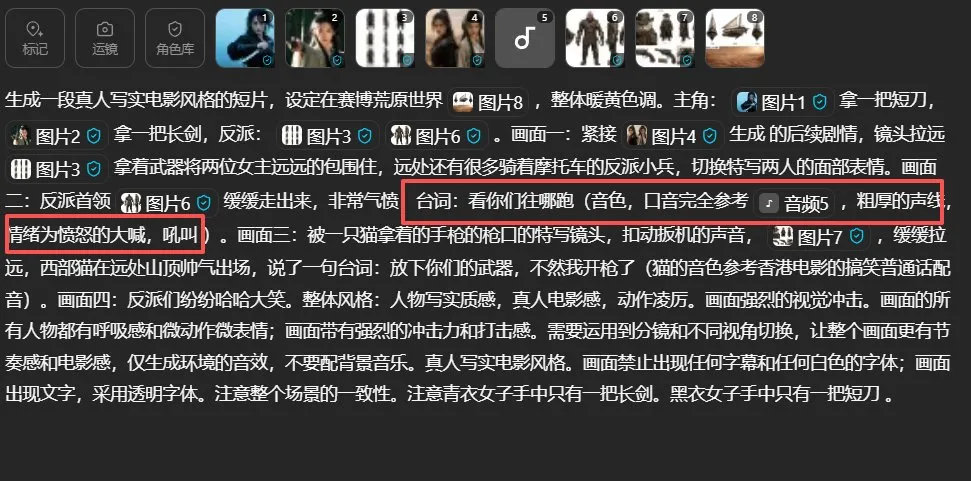
有了音频文件,提示词参考下面的结构撰写即可,可以加入情绪描述等辅助描述
方法二:先生成人物配音,再用参考音色
如果想提前固定好音色,或者对于seedance 2.0生成的音色不满意,或者想用某个专属的音色,seedance没有。可以用这个方法。
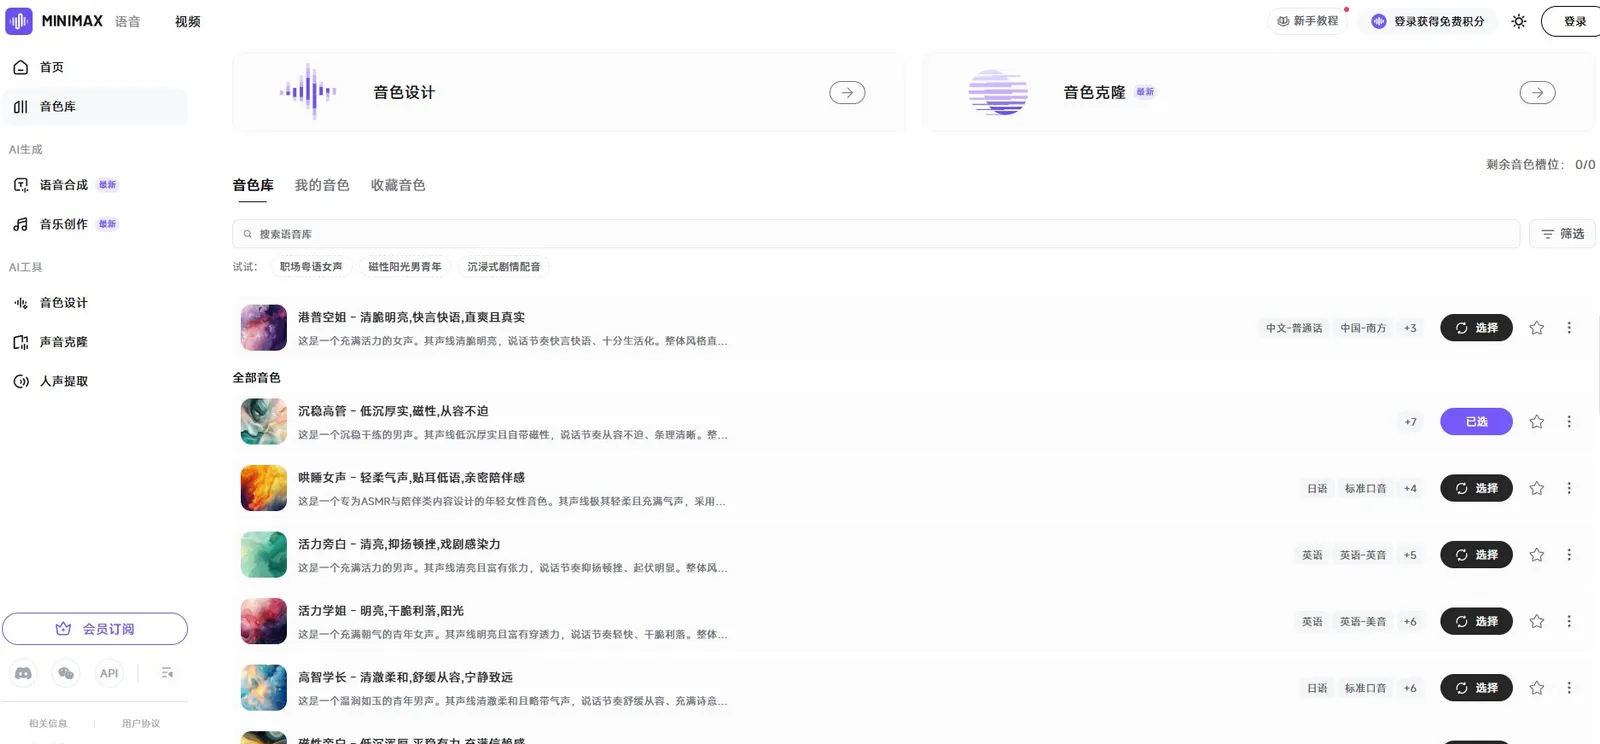
流程:配音软件生成音频→下载音频文件→上传音频作为参考→提示词描写:音色参考该音频(提示词与方法一完全一样)
推荐几个配音工具:Minimax,IndexTTS
方法三:先生成每段段配音,再用seedance直接引用这段配音
该方法比较麻烦,需要一段段在配音软件生成,然后再传到seedance 2.0 作为参考视频。对于音色,人物说话情感要求高的,可以使用该方法。
流程:配音软件生成音频→下载音频文件→上传音频作为参考→提示词描写:说出这句话:参考该音频
推荐的工具跟方法二一样。
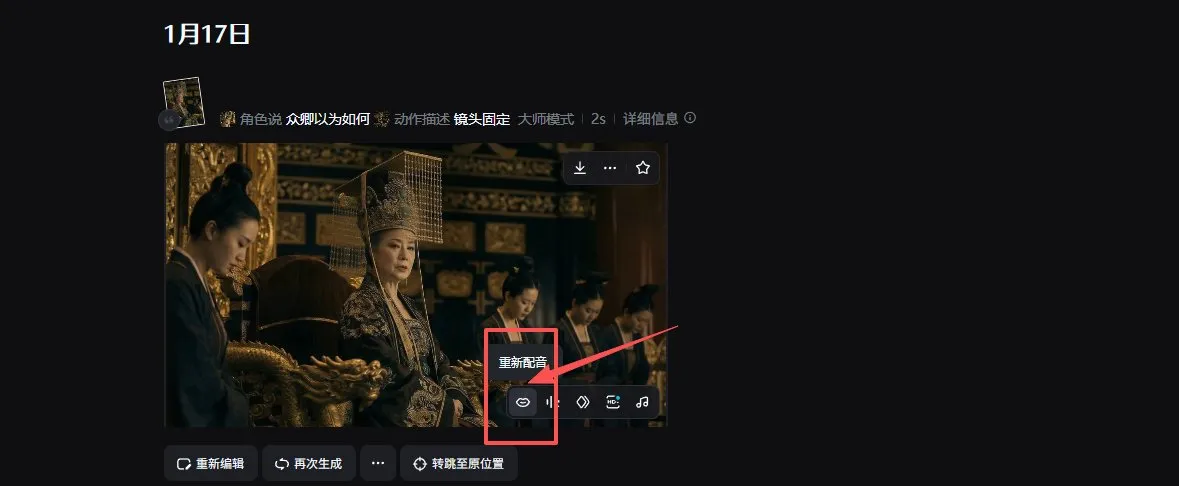
另外 即梦的对口型功能,也有很多音色可以选择。如果使用即梦做视频比较多的,可以直接在上面生成
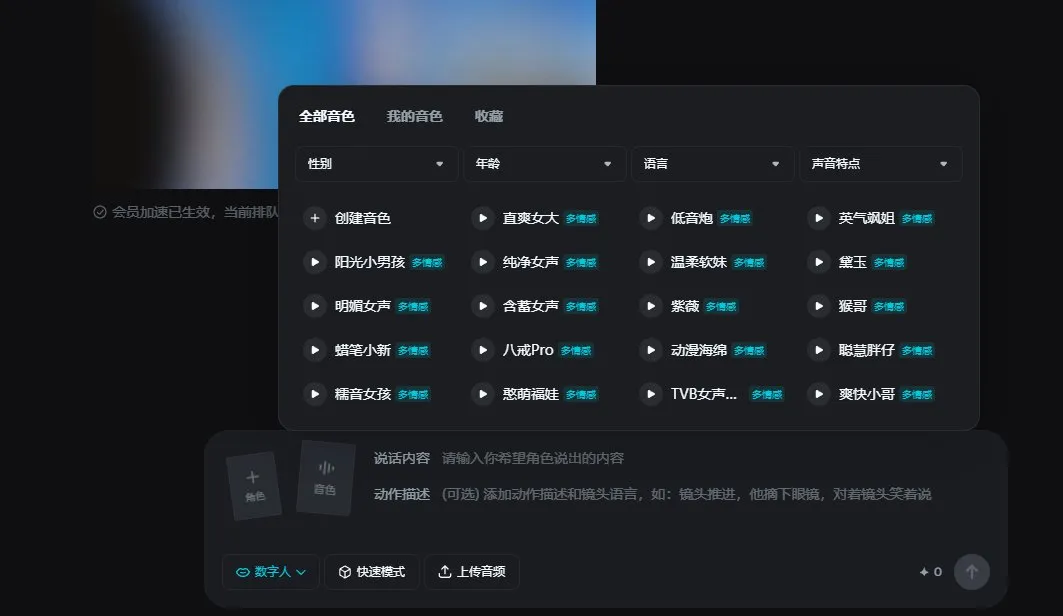
也可以生成视频了,再用对口型功能 进行配音修改
以上是seedance 2.0 保持人物音色一致性的三种常见玩法。
后面我将陆续更新 包括 如何让人物配音更自然,如何使用场景锚定图,固定画面人物位置 等基础实操。感兴趣的朋友,欢迎点赞和关注。
完整AI短片/短剧 制作流程分享,欢迎添+V了解:Path_tanluai